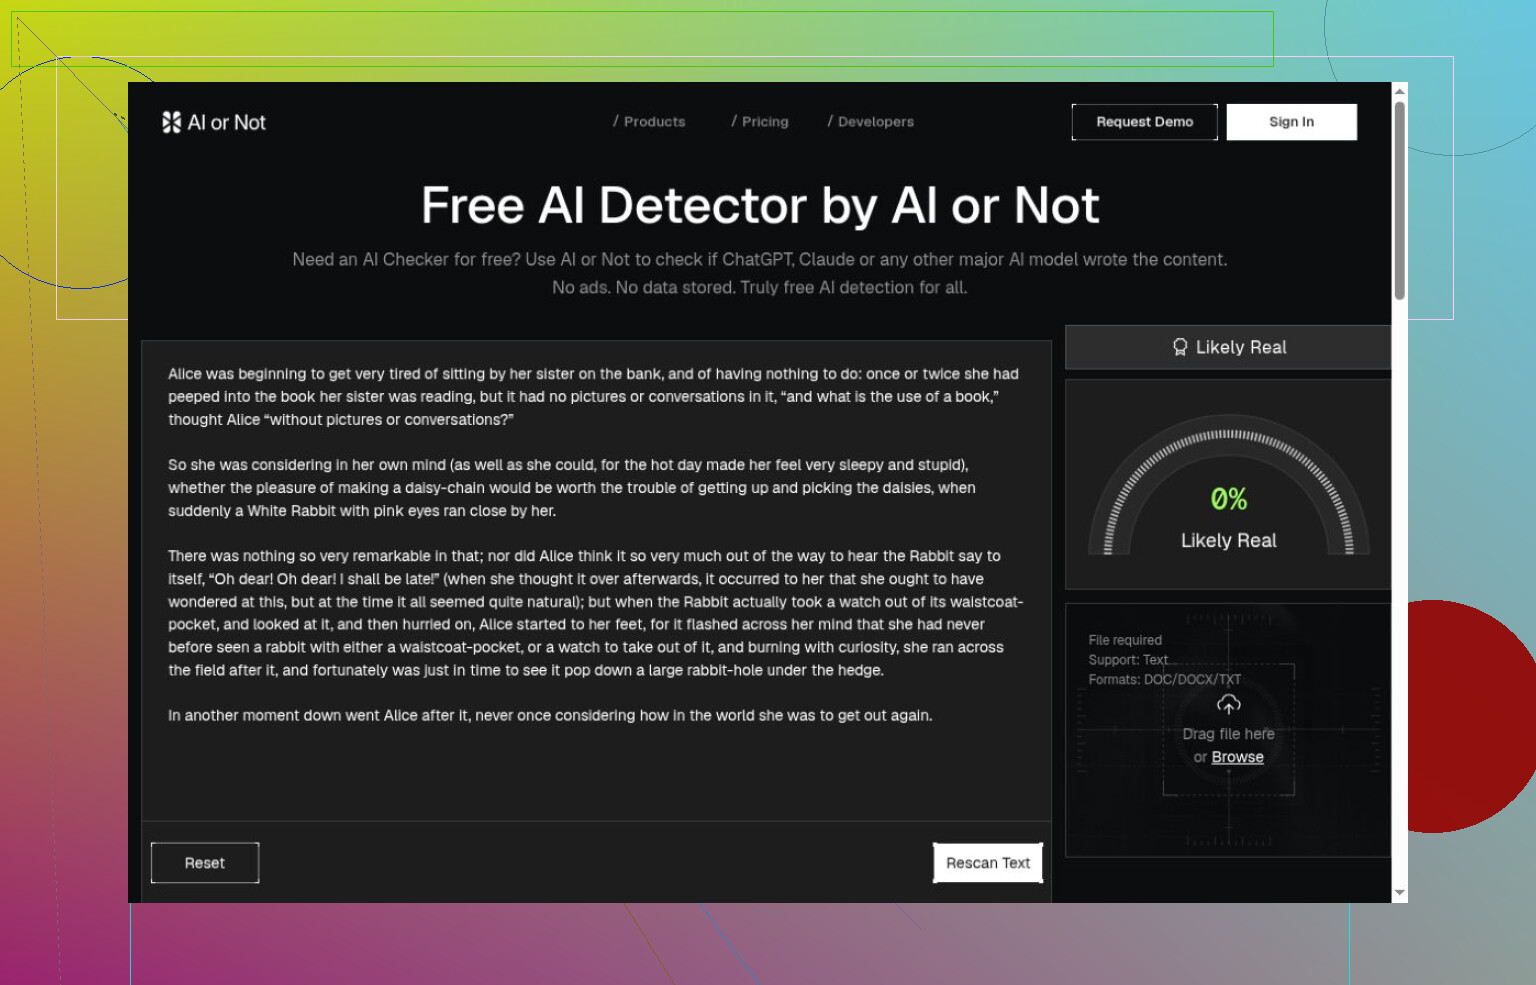
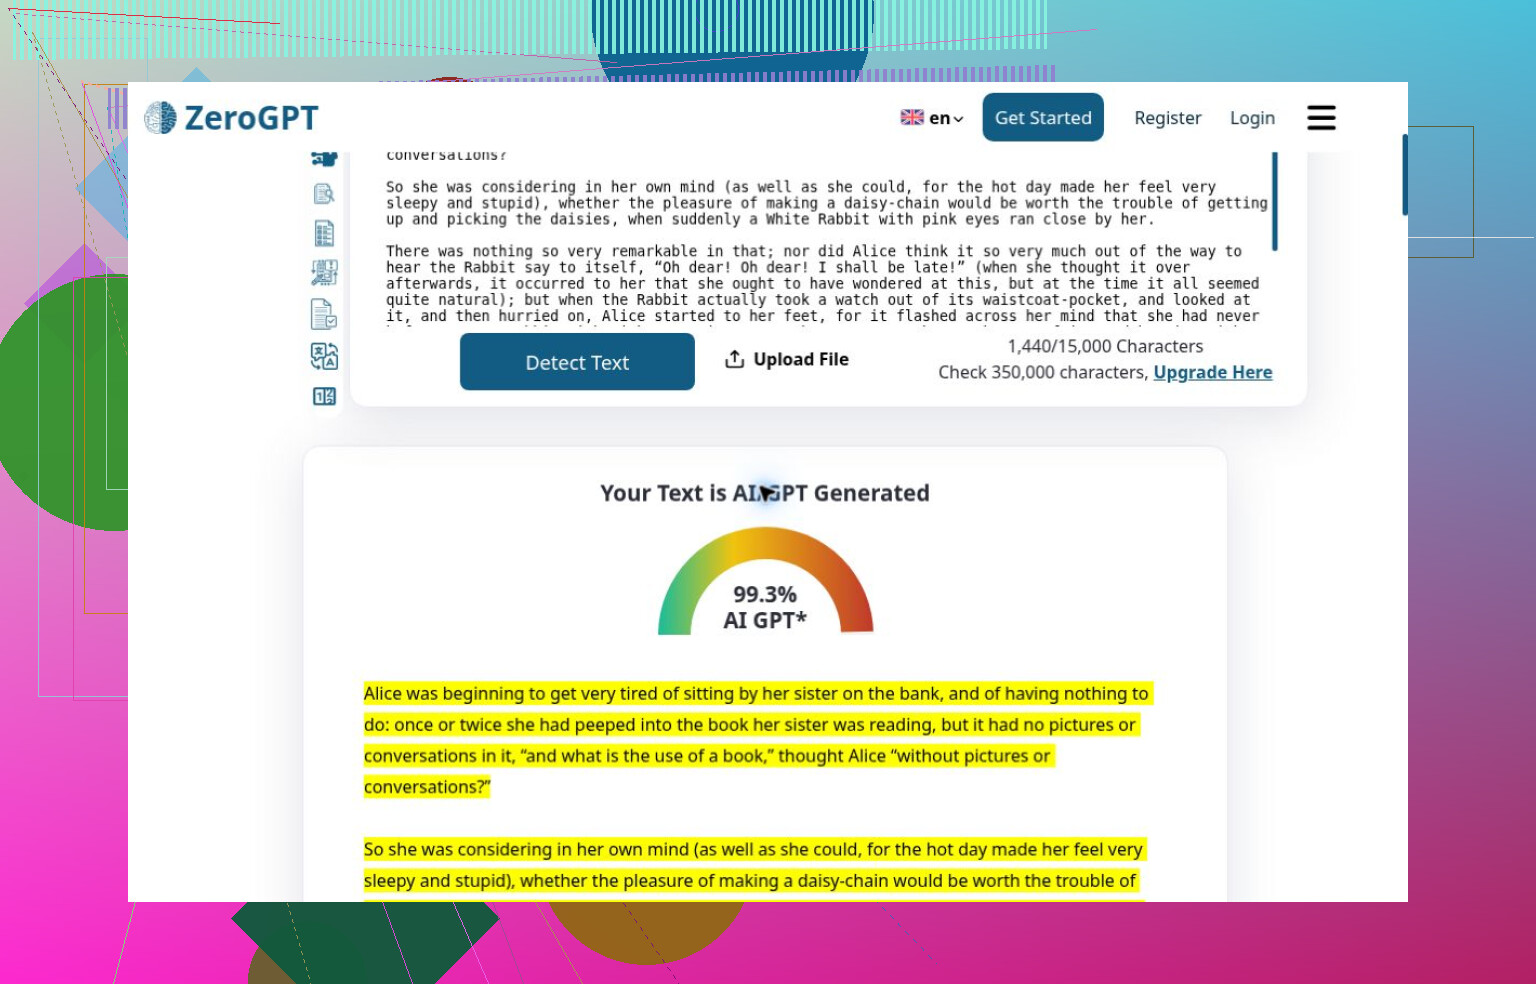
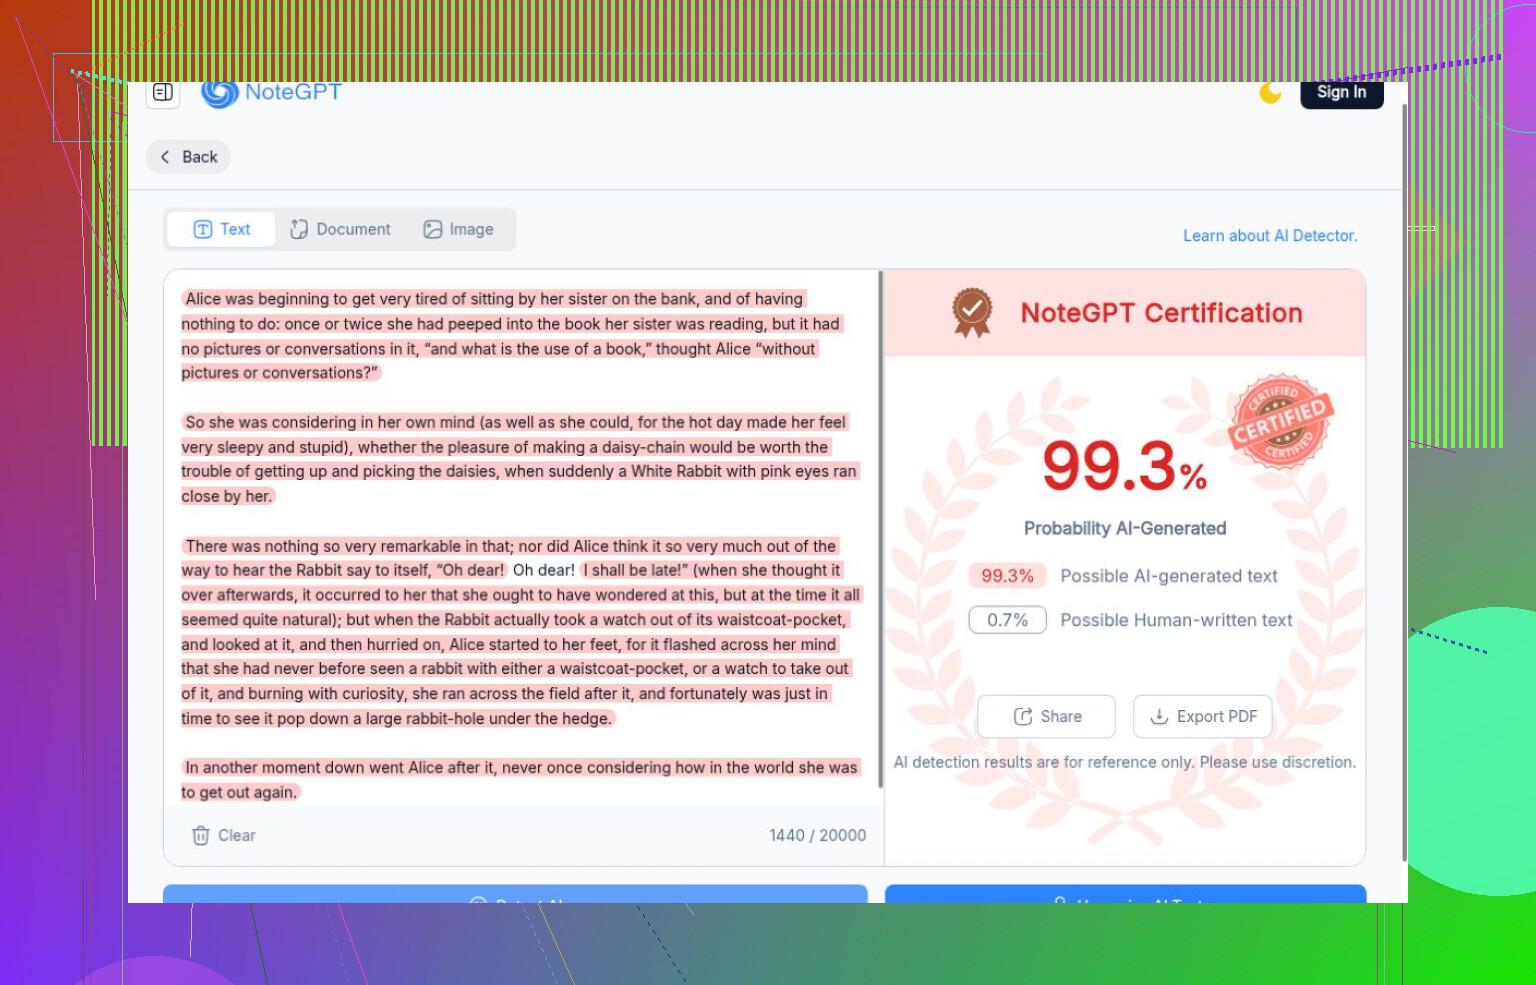
El primer error que corregiría es considerar una clasificación como IA con un alto grado de confianza como prueba de autoría. En mis comprobaciones, ZeroGPT y NoteGPT asignaron al fragmento de Lewis Carroll sus puntuaciones de IA más altas, por encima de las de los textos generados. ZeroGPT lo clasificó como un 99,3 % de IA. Eso me lleva a buscar muestras de control de autoría humana conocida antes de dar mucho peso a las detecciones acertadas.
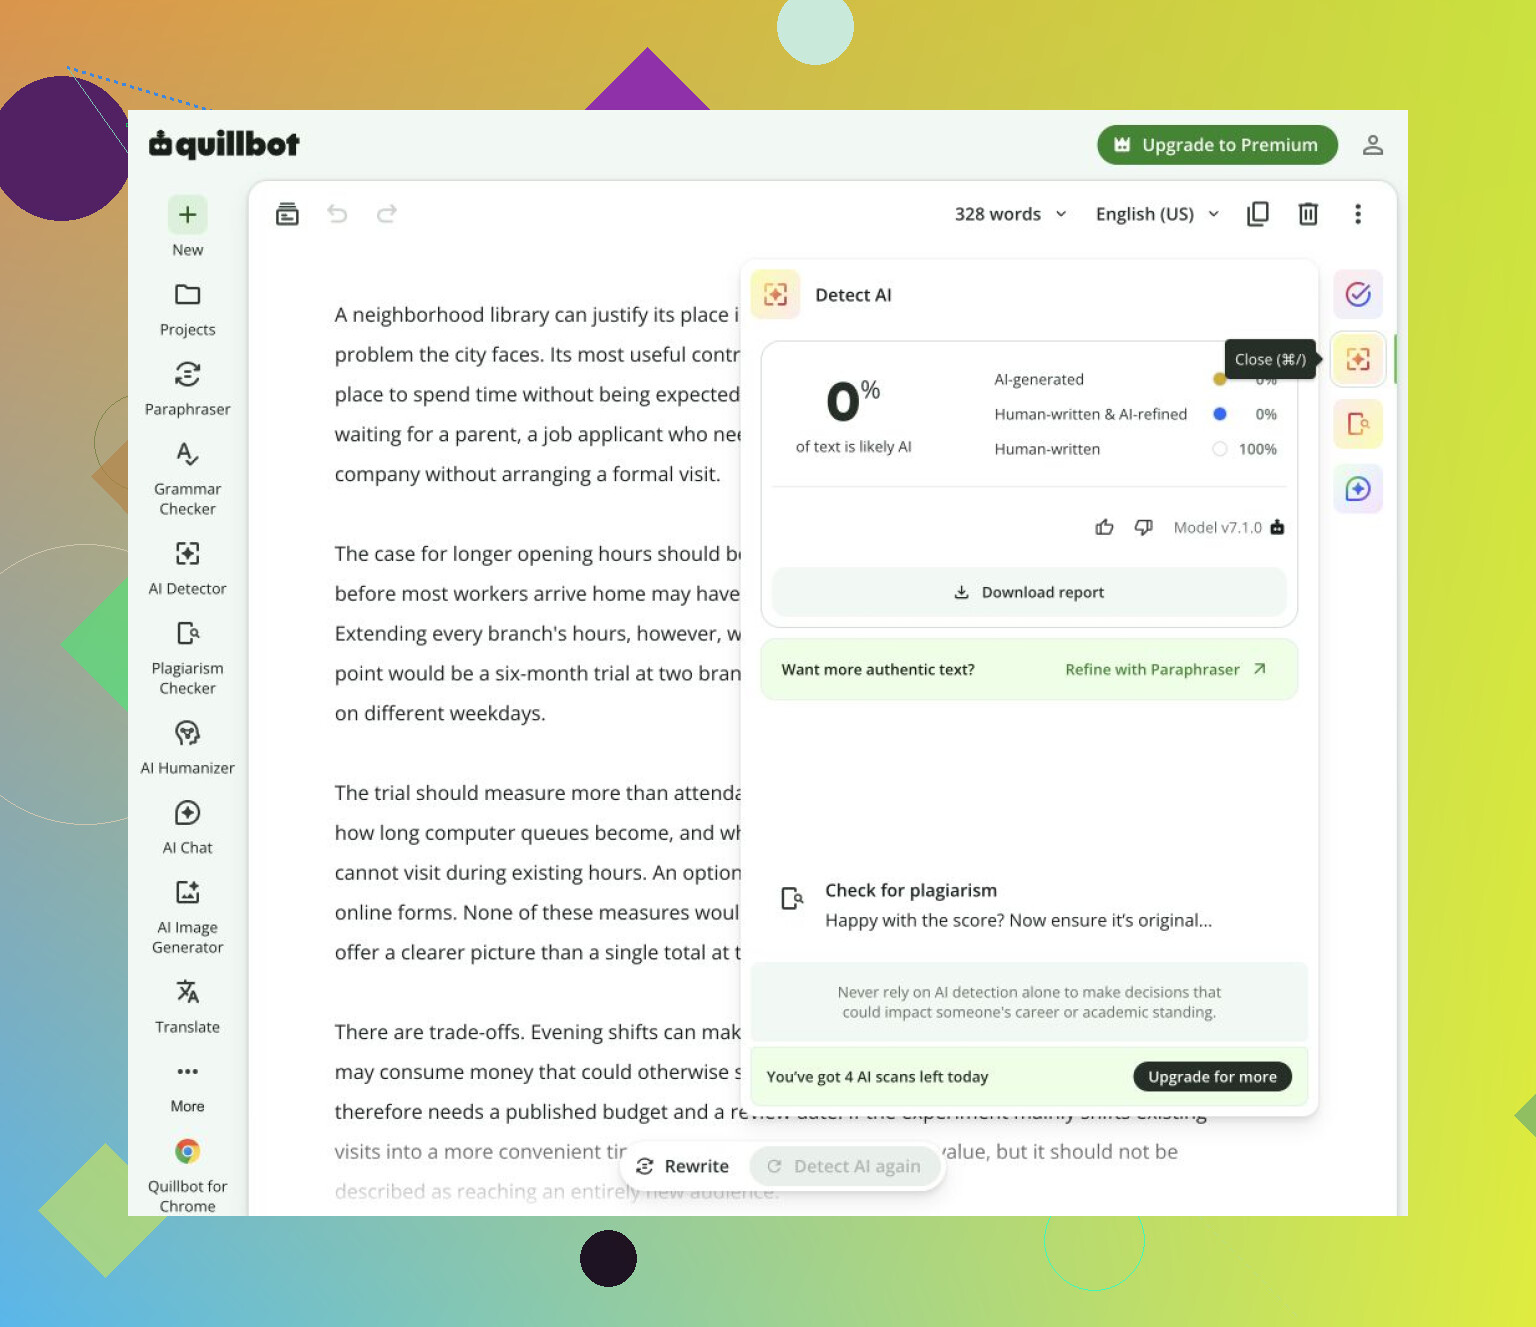
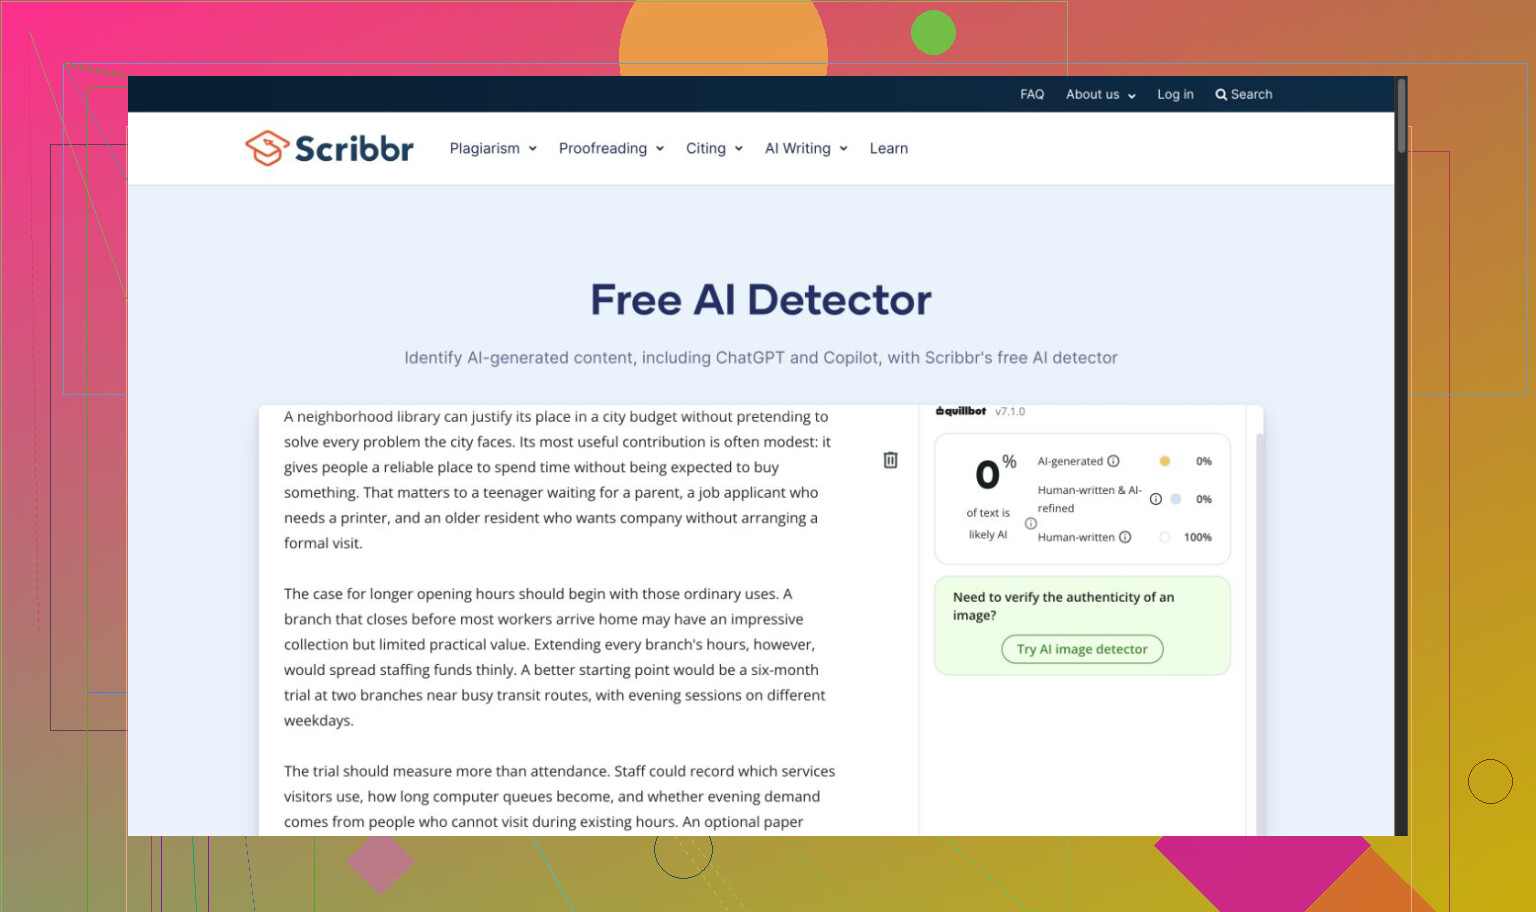
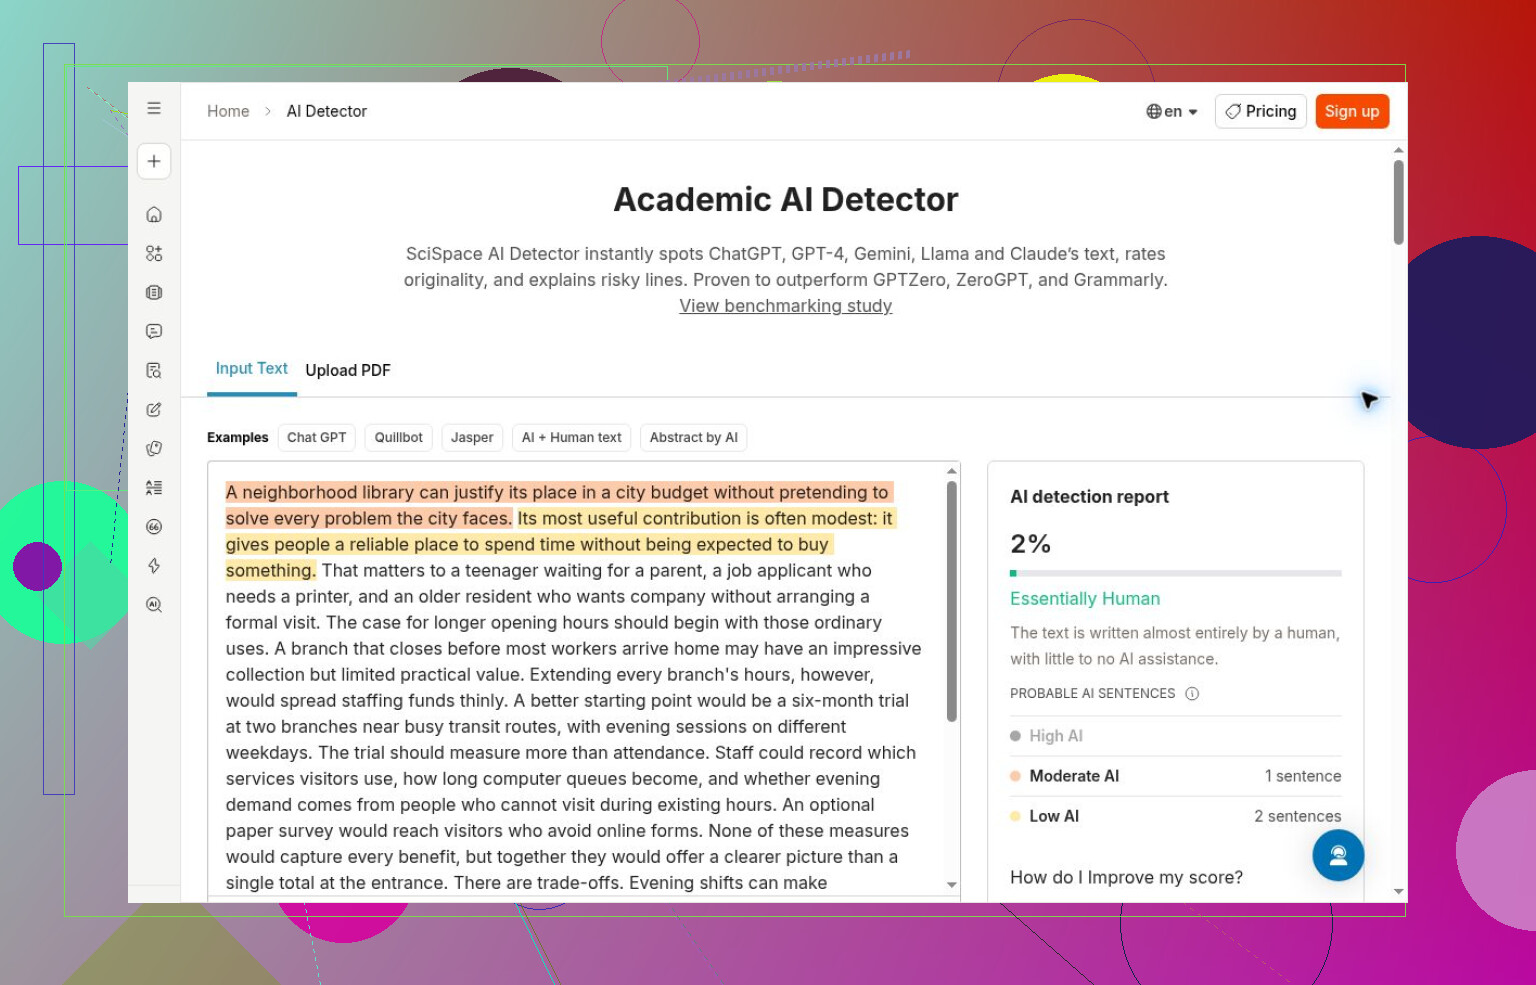
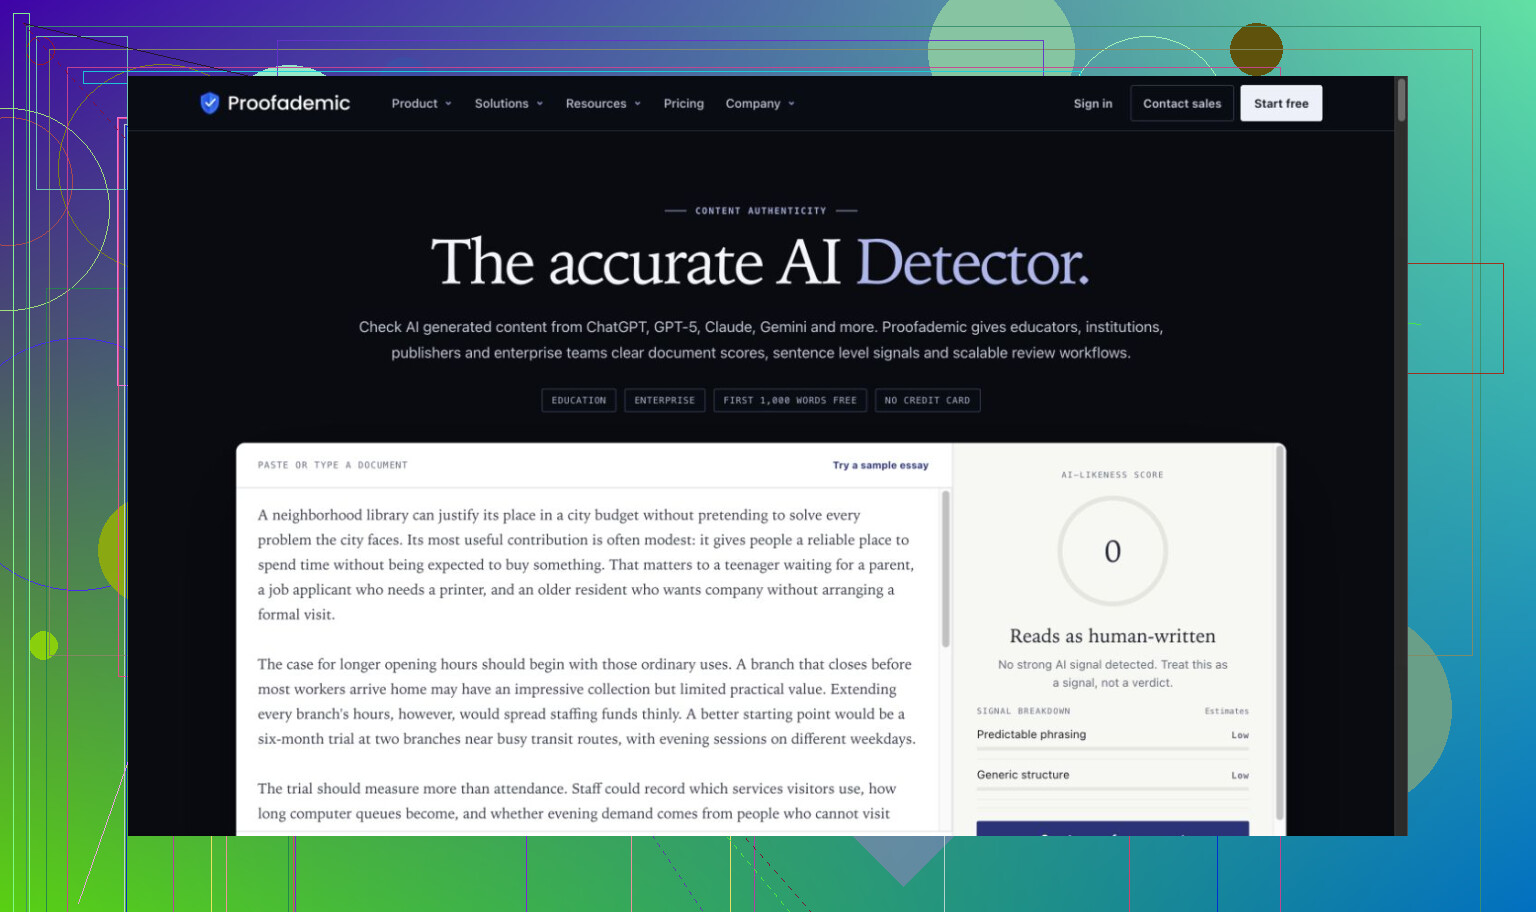
Los errores en sentido contrario también fueron importantes. QuillBot aceptó los cuatro pasajes generados como humanos. Scribbr no detectó el ensayo generado, al igual que SciSpace y la demostración pública de Proofademic. Surfer no detectó ni el ensayo ni el relato generados. No puedo explicar esos fallos a partir de las capturas de pantalla. Scribbr también mostraba la marca de QuillBot, así que no consideraría automáticamente la coincidencia entre ambos como una confirmación independiente.
Utilicé seis pasajes en inglés sin modificarlos los días 2 y 3 de octubre de 2026: textos generados en formato de ensayo, memorando, paráfrasis y relato personal ficticio, un fragmento de Carroll y una versión de ese fragmento editada con IA. Algunos pasajes estaban relacionados. Fue una comparación limitada, no una prueba aplicable a los textos de todo el mundo, y no evalué los flujos de trabajo de pago ni la cobertura multilingüe.
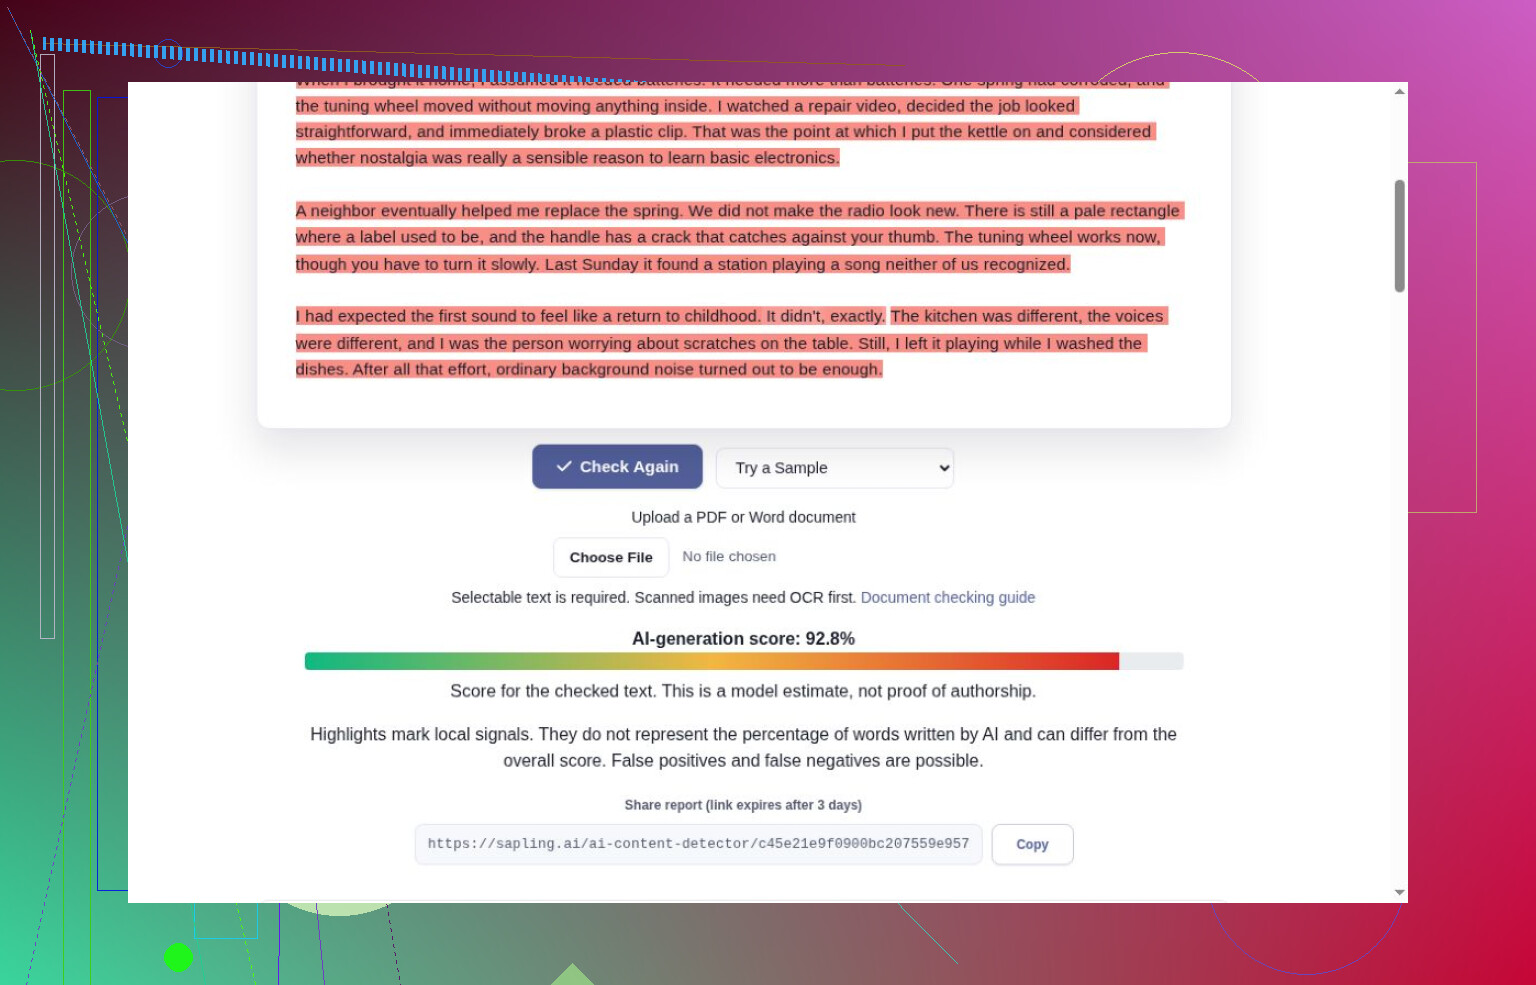
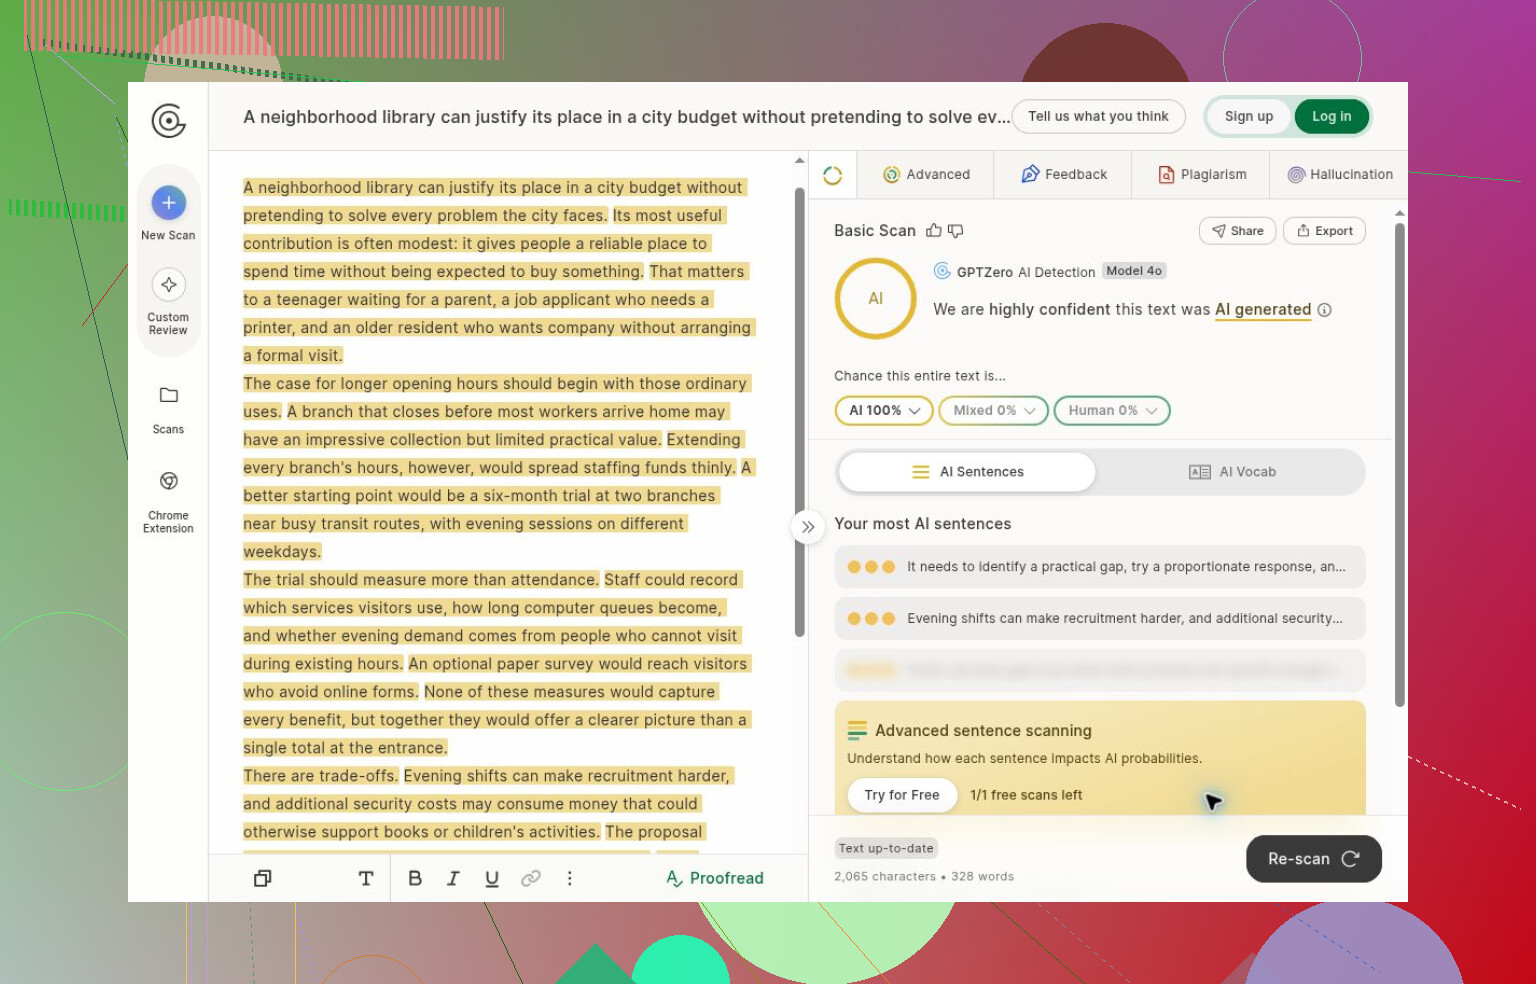
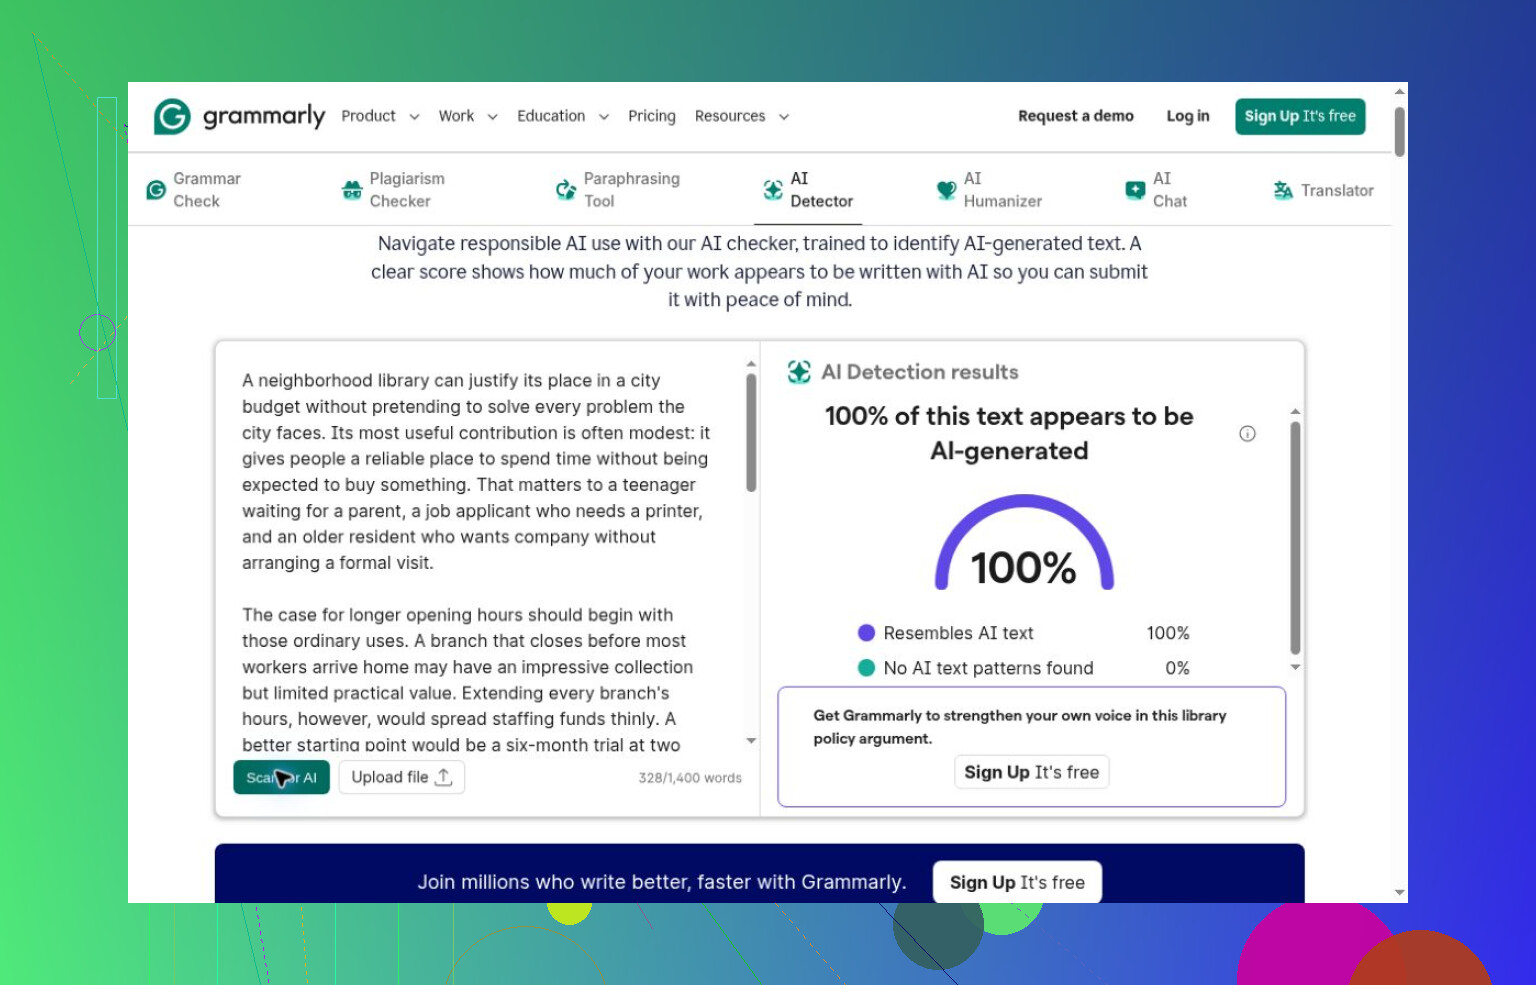
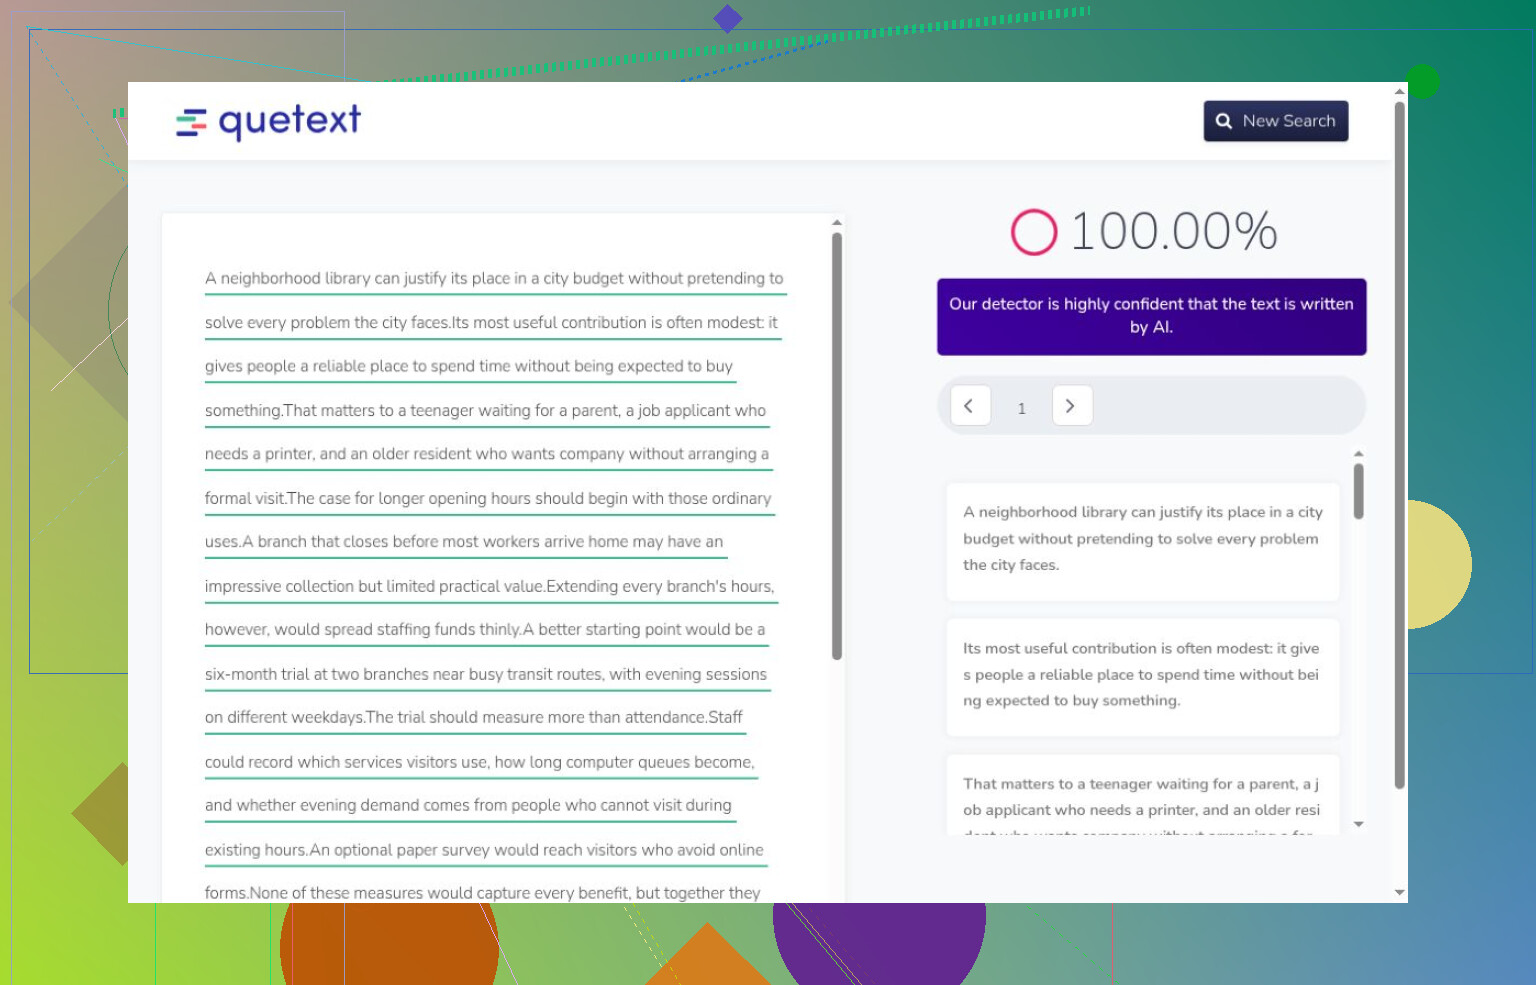
También distinguí entre un resultado completado y una interfaz que solo aparentaba haber terminado. GPTZero conservó una puntuación anterior después de que sustituyera el texto de entrada; eso no constituía otra detección. Sapling solo analizó una parte del ensayo, aunque sus comprobaciones completas del relato y del texto humano fueron correctas. GPTZero, Grammarly y Quetext identificaron correctamente el material generado que procesaron, pero las restricciones por no tener una cuenta me impidieron probar muestras de control humanas con ellos. Sus detecciones acertadas no permiten determinar su comportamiento frente a los falsos positivos.
Para repetir este pequeño ejercicio con acceso de invitado, empezaría por la herramienta de detección de IA de Clever. Completó el conjunto de pruebas sin pago ni registro, detectó los pasajes generados y aceptó el de Carroll. No pude verificar el uso ilimitado ni la longitud máxima que anunciaba. Los colores de las frases y sus explicaciones a veces discrepaban del resultado principal, y aceptó el pasaje ligeramente editado como humano.
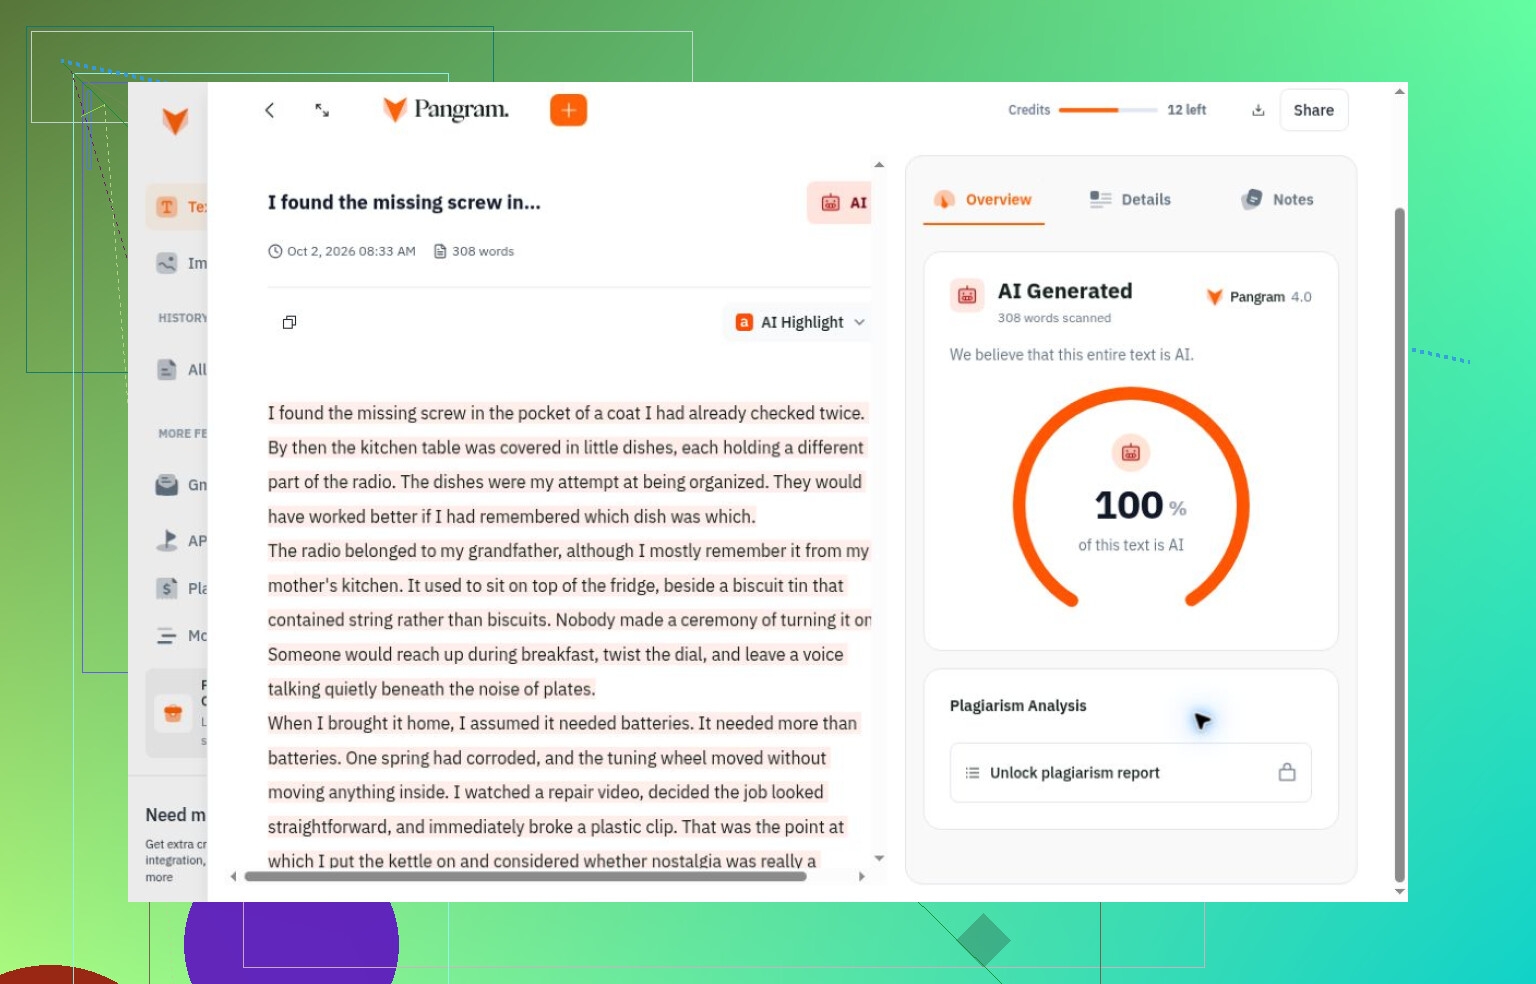
Pangram también aceptó ese pasaje editado, mientras que clasificó correctamente los textos generados y los originales humanos en las comprobaciones que completó. Sus créditos se agotaron, y el consumo dependía de la longitud. Originality.ai y AI or Not también acertaron en las comprobaciones de textos generados y humanos que completaron, aunque con una cobertura más limitada. El grado de confianza de Originality.ai se aplicaba a un veredicto según el umbral de tolerancia seleccionado, no a una proporción medida de palabras generadas. No compararía la confianza, la probabilidad y la proporción estimada de IA como si fueran valores intercambiables.
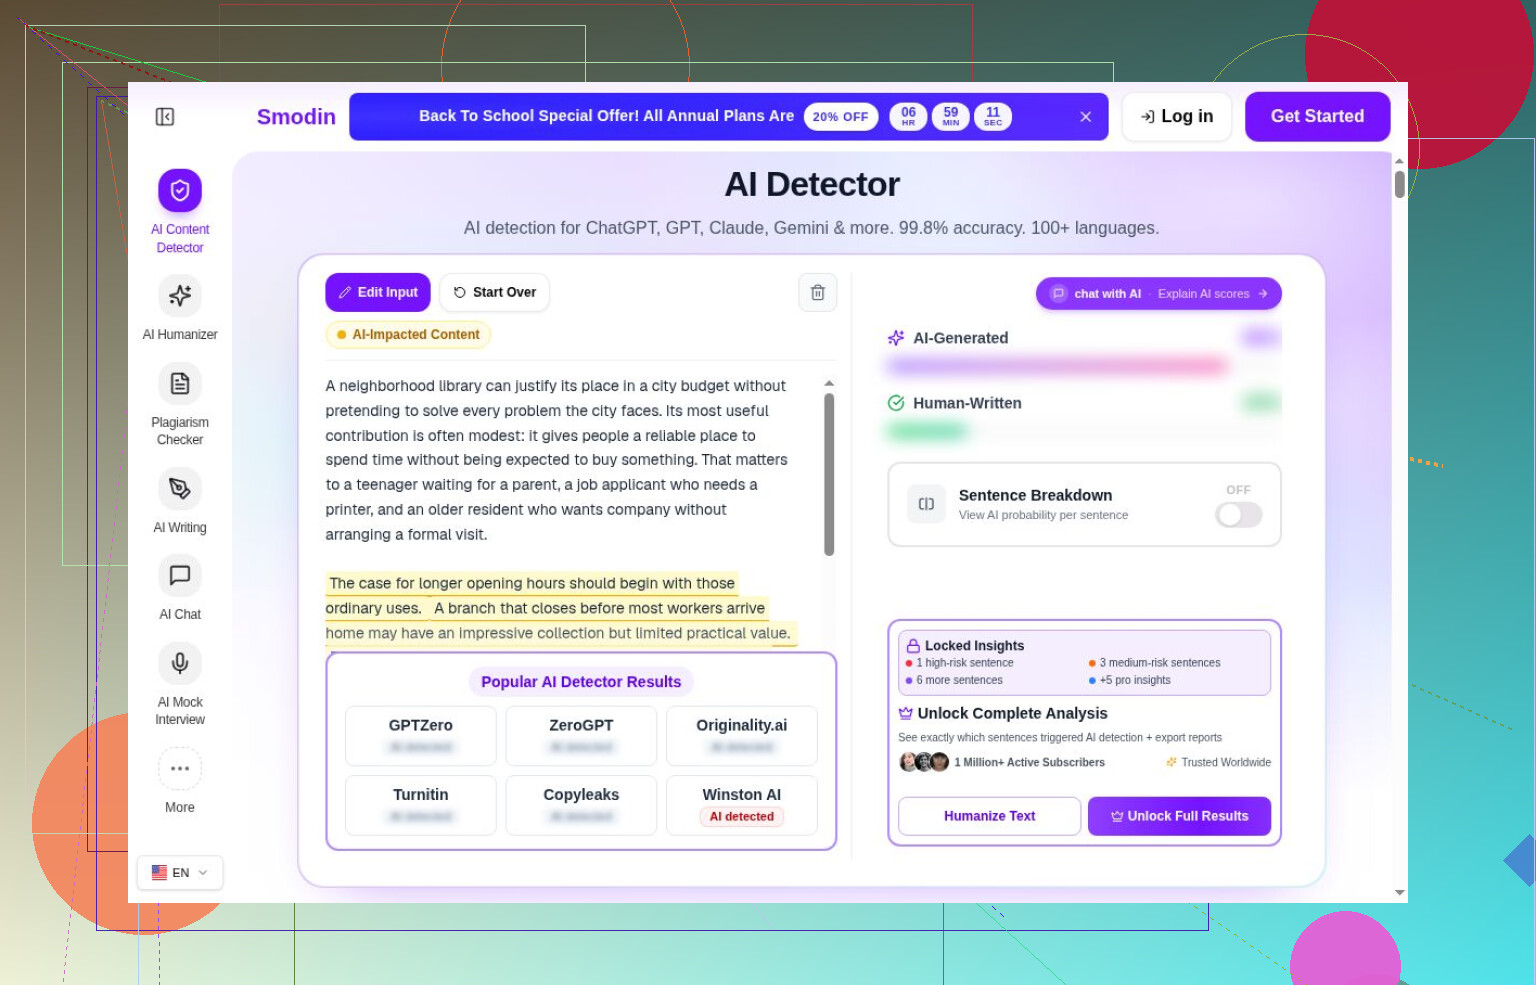
Las observaciones limitadas al acceso no me dicen nada sobre la precisión. Decopy pidió iniciar sesión; Smodin ocultó sus valores principales. AI Detector Pro y Winston AI exigían registrarse, mientras que Turnitin requería acceso institucional. Me detuve ante las condiciones de uso aplicables de Copyleaks, no ante un análisis fallido. Las vías de análisis de texto de Hive requerían una extensión o una API; ContentDetector.AI redirigía a la página de una extensión de Moxby. No instalé ninguna de las extensiones ni la aplicación de Humanly, y no pude verificar su capacidad de detección ni sus límites de uso gratuito.
Para probarlo por tu cuenta, utiliza textos cuyo origen puedas documentar, incluidos tus propios borradores, muestras generadas y mezclas editadas etiquetadas por separado. Envía copias idénticas, confirma que cada resultado sea nuevo y abarque todo el pasaje, y guarda los resultados. Compara los errores por categoría en lugar de promediar puntuaciones de distinta naturaleza. Yo usaría esos registros para valorar la utilidad, no para convertir la clasificación de un detector en una acusación.